
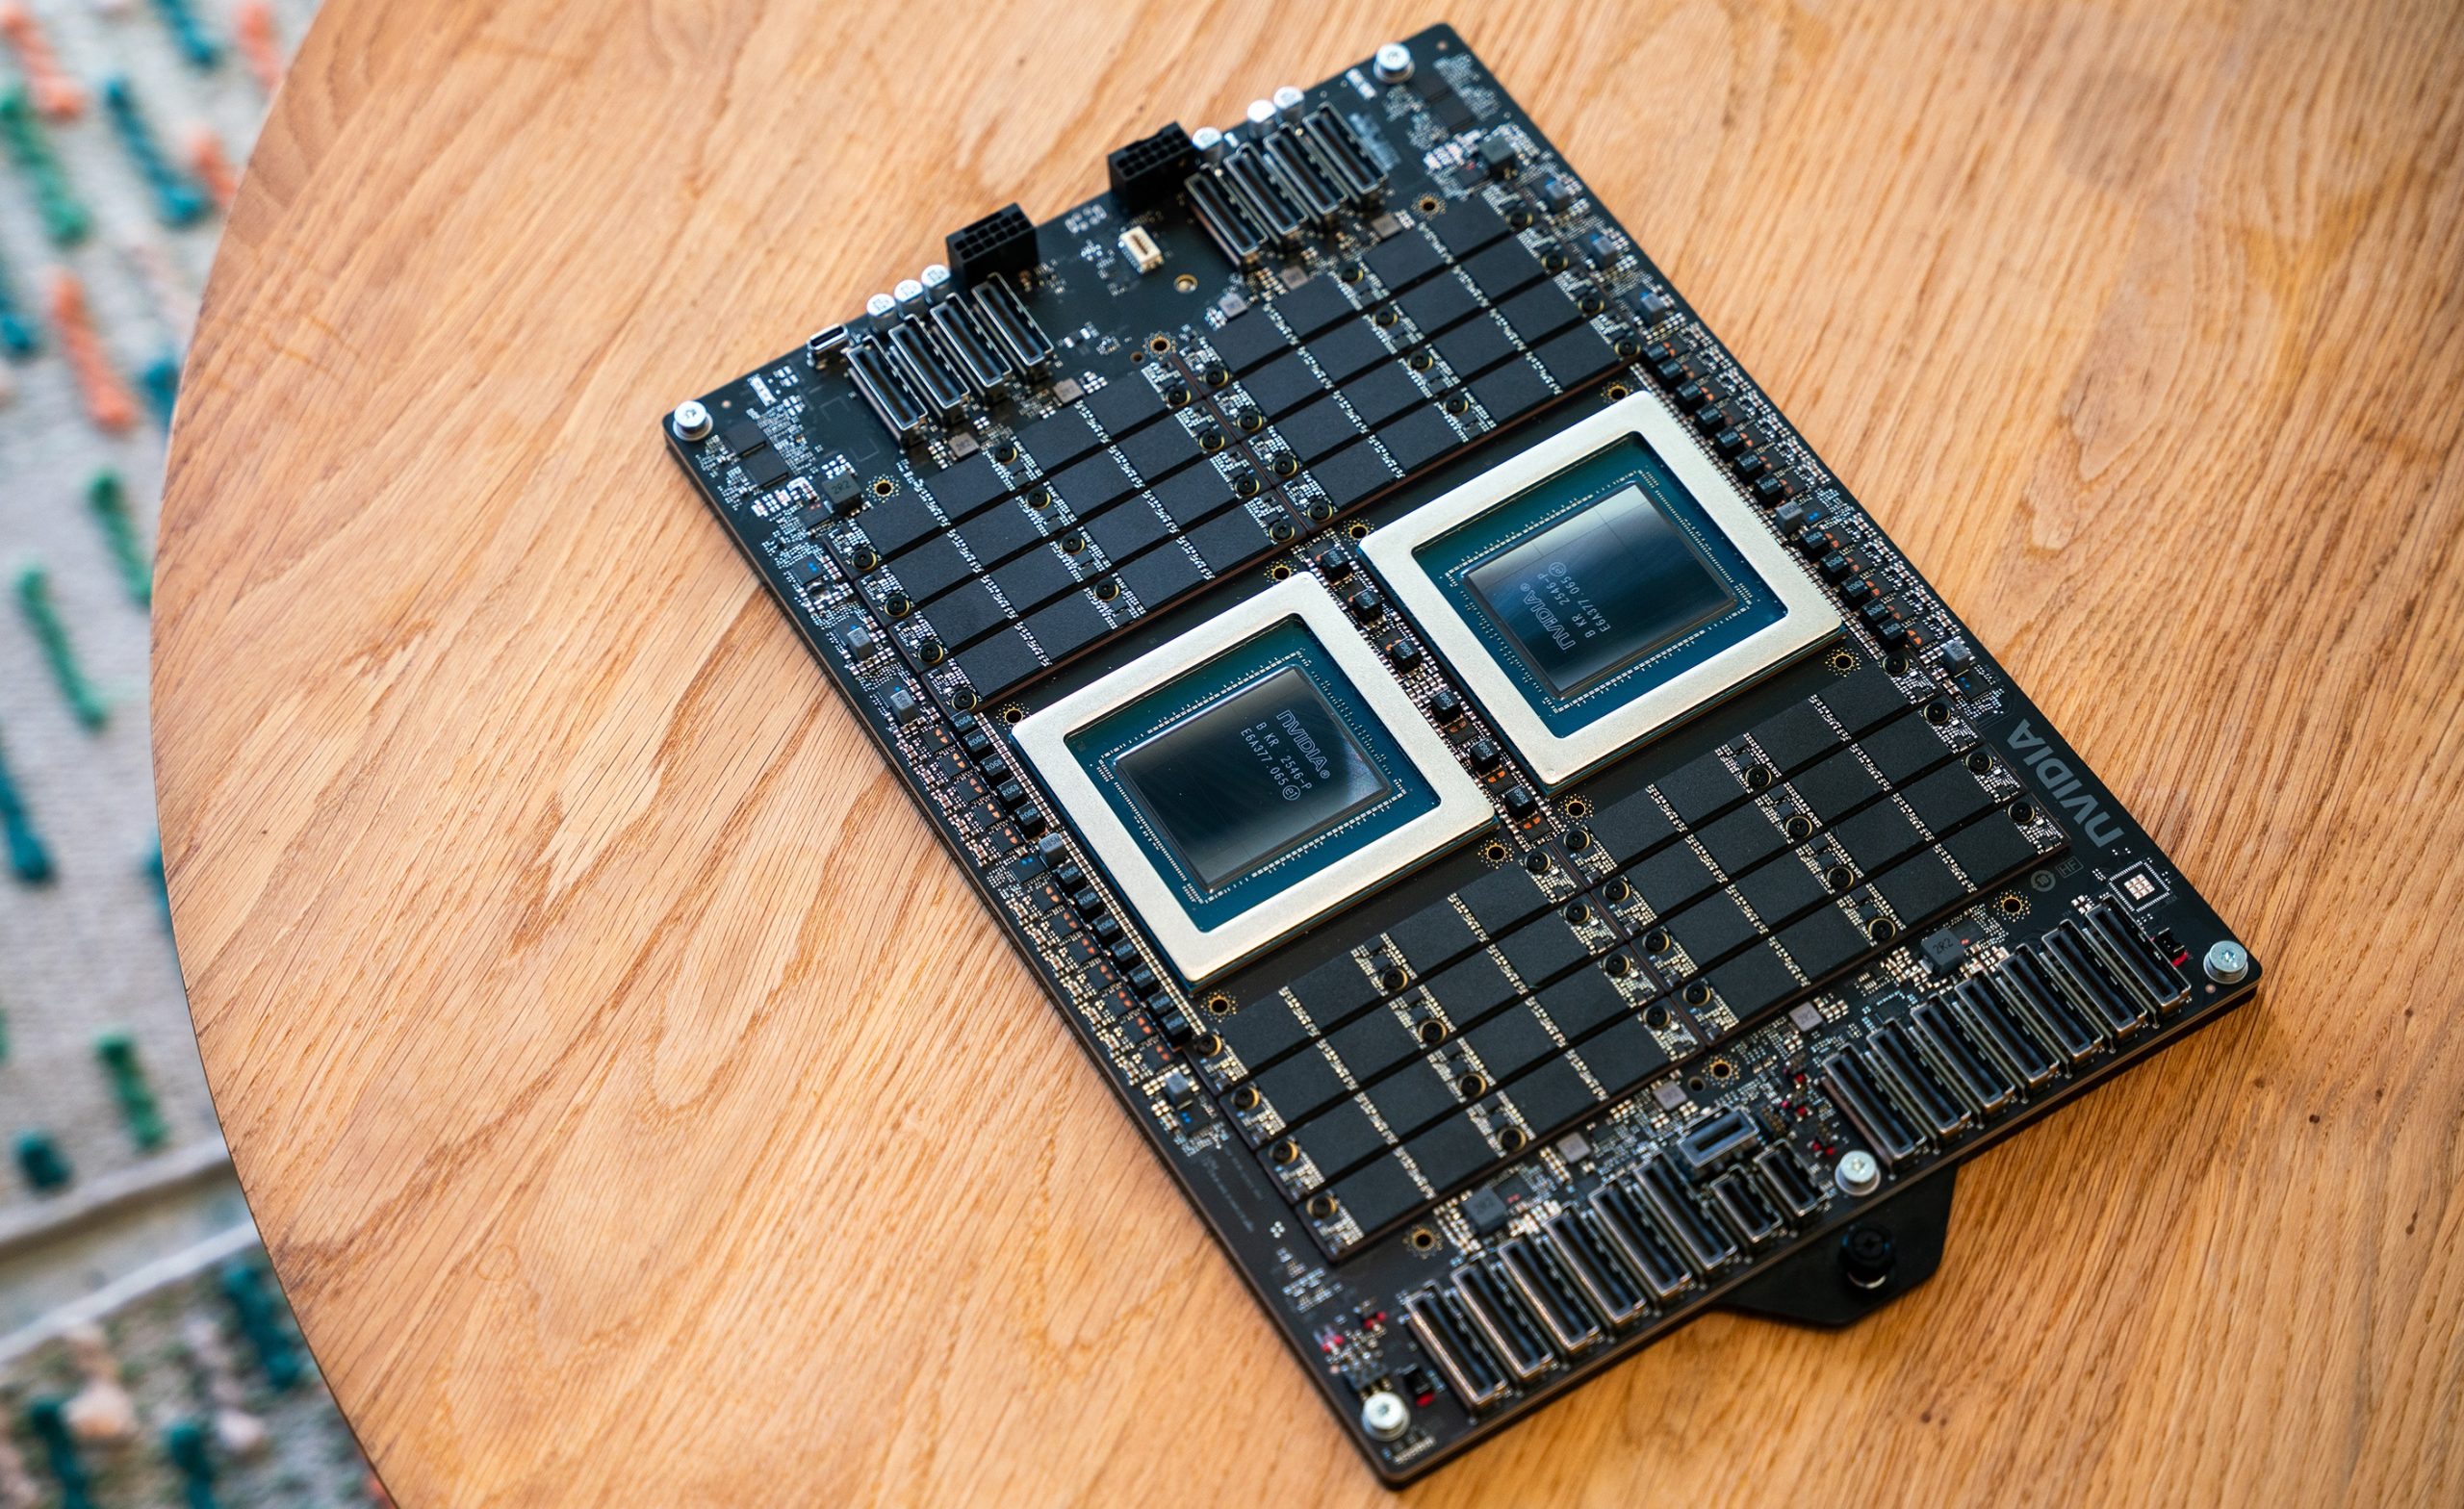
Az NVIDIA Vera CPU-ja a számítástechnikai architektúra újradefiniálását jelenti a hagyományos, feladatszigetelt paradigmából egy összehangolt, ügynöki intelligencia ökoszisztémává, áthelyezve a központi feldolgozóegység (CPU) szerepét egy általános célú multitaskerről egy speciális karmesterré, amelyet kifejezetten az AI-ügynökök kaotikus, többlépcsős érvelési hurkainak kezelésére terveztek.
A közelmúltban a Wccftech lehetőséget kapott arra, hogy leüljön az NVIDIA Vera csapatával egy informatív tête-à-tête-re a CPU feltörekvő szerepéről a gyorsan növekvő ügynöki mesterséges intelligencia gazdaságban. Tehát áss bele, miközben az egyszálú teljesítmény újjászületését, a CPU-vezérelt AI homokozók megdöbbentő skáláját és a változó CPU-GPU arányt tárgyaljuk.
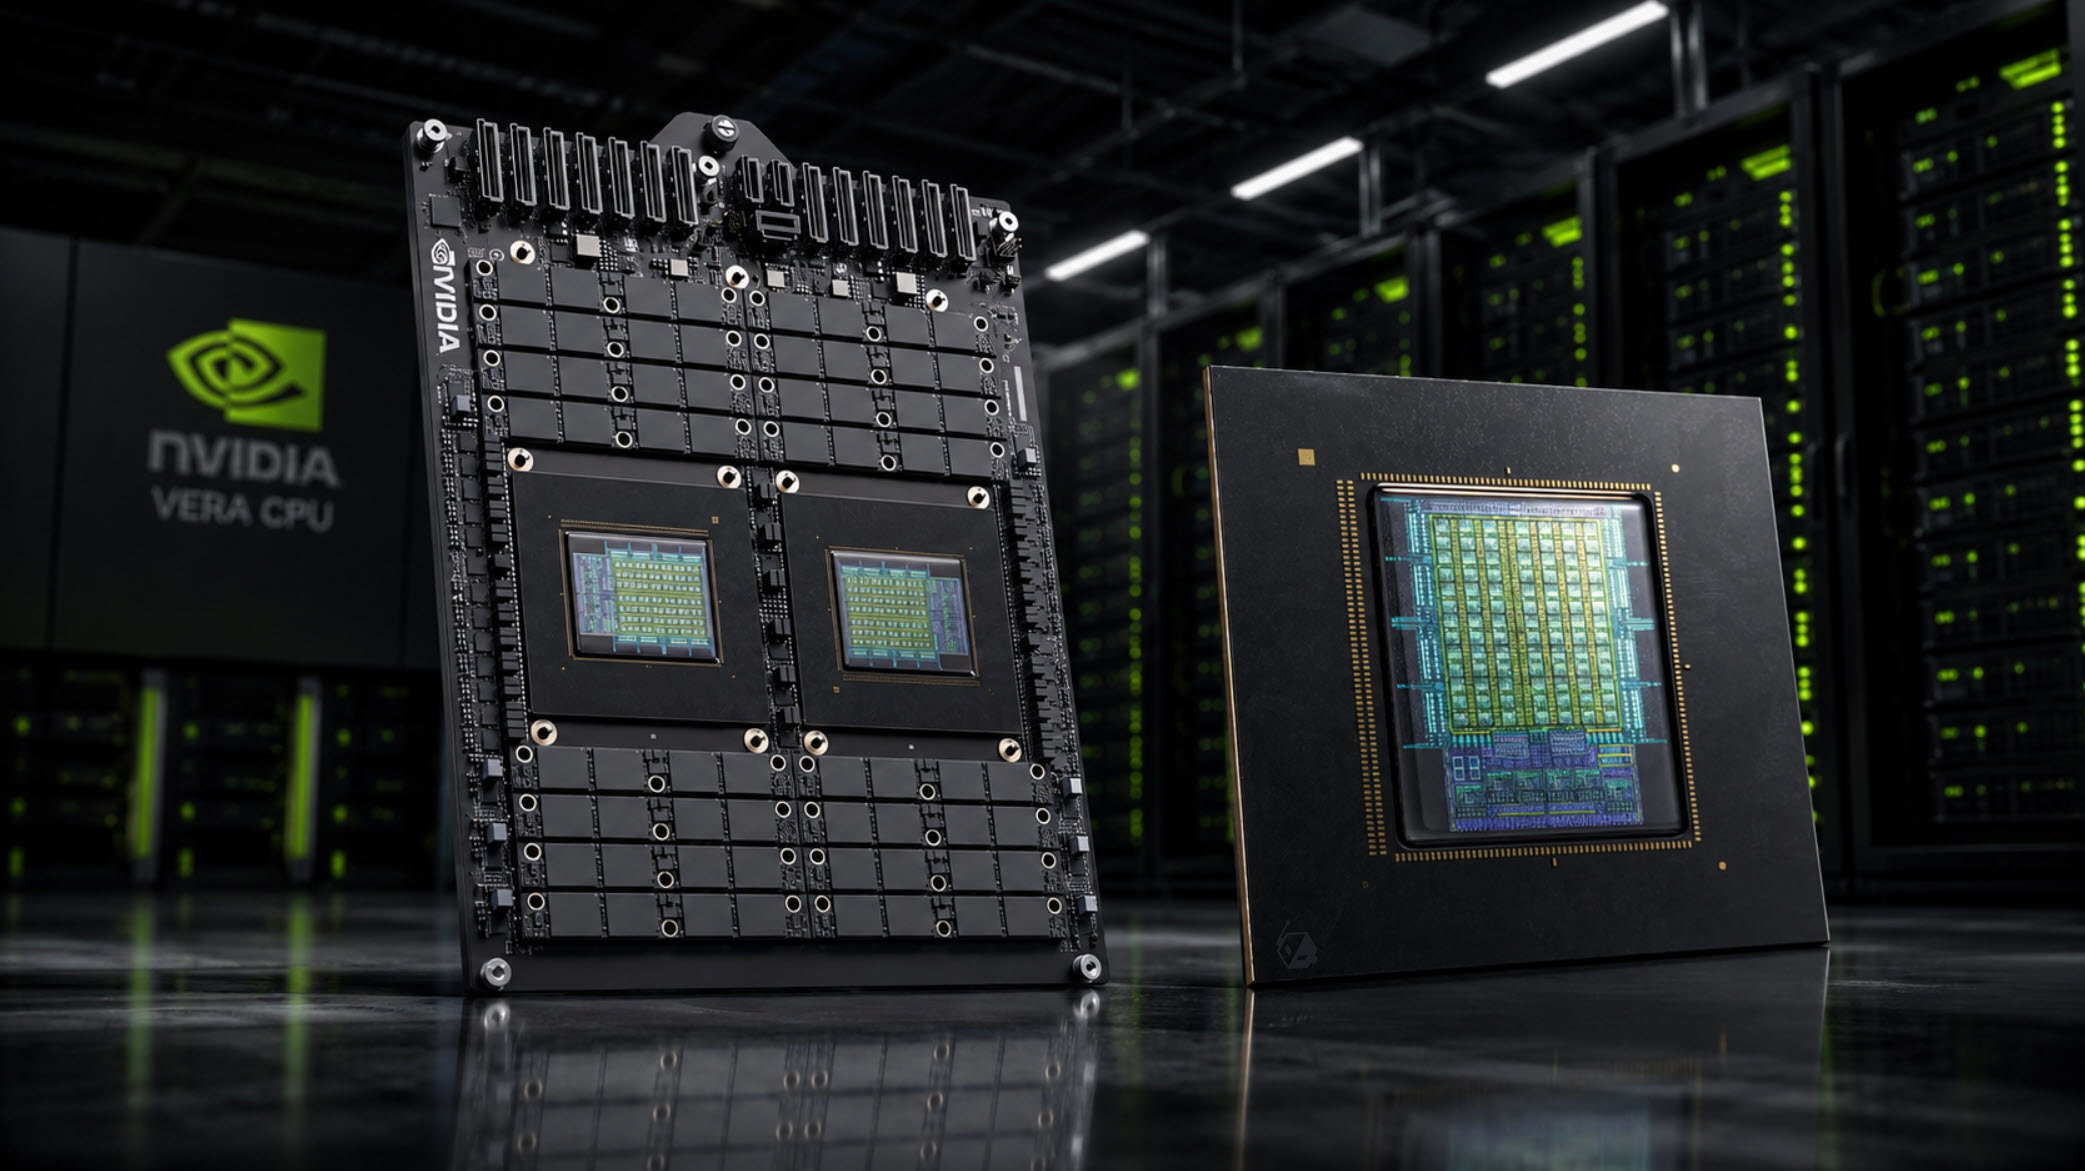
Miután évekig a felhőinfrastruktúra a hatalmas magszámlálást helyezte előtérbe a magonkénti sebesség rovására, az ügynöki mesterséges intelligencia megfordulást kényszerít, és az NVIDIA Vera ennek a paradigmaváltásnak a megnyilvánulása
Kérdés: Tudna rövid áttekintést adni arról, hogy miről szól a Vera CPU?
Válasz: A 2010-es évek elején az adatközpontok kialakítása az egyes processzormagok teljesítményének maximalizálására összpontosított, nem pedig a magok puszta mennyiségére. Ebben az időszakban az olyan piacvezetők, mint az Intel, olyan architektúrákra összpontosítottak (mint például a Haswell generáció), amelyek kevesebb, magasabb órajelfrekvencián futó magot tartalmaztak.
Ez a korszak a CPU-tervezés bal felső kvadránsában ült, amelyet nagy egyszálú teljesítmény, de alacsony általános átviteli sebesség jellemez.
„Ez egy olyan időszak, amikor az Intel vezető szerepet töltött be az adatközpontok piaci szegmensének részesedésében… magas az egyszálas perf, de alacsony az áteresztőképessége, mert nincs annyi magja.”
Ahogy a hatalmas felhő hiperskálázók növekedtek, az iparág a méretgazdaságosság felé fordult. A kereslet arra irányult, hogy a lehető legtöbb magot egyetlen szerverbe csomagolja, hogy maximalizálja a szerveregységenkénti bevételszerzést. Ennek a sűrűségnek és vezérlési költségeknek az elérése érdekében az x86-os gyártók az egychipes kialakításról a többlapkás elrendezésre váltottak. Ez a hatalmas bővülés azonban a magszámban az egymagos optimalizálás és a ciklusonkénti utasítások (IPC) közvetlen költségén történt.
Ez a korszak a jobb alsó kvadránst foglalta el – hatalmas áteresztőképességet kínálva, de alacsony egyszálú teljesítményt.
„…ami ez idő alatt szenvedett a CPU-tervezés szempontjából, az valóban egyszálú perf és IPC volt, mert amikor kitölti, amikor chipleteket használ, akkor szó szerint nincs hely a chipen, hogy a magperf-re tervezzen.”
Az Actionic AI felemelkedése visszahelyezte a CPU-t a hardvertervezési útvonal középpontjába. Az AI ügynökök folyamatos, gyors hurokban működnek a GPU és a CPU között. Mivel a GPU-k a legdrágább és legértékesebb eszközök egy AI-gyárban, a CPU-nak azonnal el kell végeznie a szekvenciális feladatokat, hogy megakadályozza a GPU üresen ülését. Ez a paradigma a sebesség, a memória-hozzáférés és a minimális késés példátlan kombinációját igényli.
„…azt szeretné, hogy az ügynök elvégezze a szükséges CPU-n végzett szekvenciális munkát, de akkor térjen vissza a GPU-hoz a következő érvelési lépéshez, mert a GPU-k még mindig a legértékesebb eszközök közé tartoznak az AI-gyárban, és így nem, meg akarja tartani ezeket az eszközöket, drága eszközöket, amelyeket magasan kihasznált…”
Az NVIDIA Vera CPU-ja megoldja az ügynöki szűk keresztmetszetet azáltal, hogy megtöri a felhőkorszak történelmi kompromisszumait, és a megfoghatatlan jobb felső kvadránsban helyezkedik el – magas egyszálú teljesítmény nagy áteresztőképességgel párosulva. Ezt három speciális tervezési lehetőség révén valósítja meg: nagy magonkénti sebesség, egyedi LPDDR5X memória-alrendszer a hatalmas sávszélesség érdekében, és egyetlen monolitikus számítási szerszám, amelyet a második generációs NVIDIA Scalable Coherent Fabric hajt a késleltetés kiküszöbölésére.
„…olyan, mint egy monolitikus kocka, az összes mag, hogy az egyetlen monolitikus számítási die, az összes mag, hogy a die tud beszélni egymással anélkül, hogy átlépné az IO határokat, és bármilyen késleltetés miatt, így ez tényleg az a fajta beállítás, hogy mi a Vera, miért gondoljuk, hogy ez a felső CPU, hogy ez tényleg beállítja ezt az új kategóriát, mint ha visszatérünk
TL:DR: A Vera az NVIDIA első kifejezetten erre a célra épített CPU-ja az ügynöki mesterséges intelligenciához, amelyet a modern AI-korszak sajátos szűk keresztmetszeteinek kezelésére terveztek. Míg a felhők korszaka a sűrű, alacsony teljesítményű chipletmagokkal rendelkező átviteli sebességet helyezte előtérbe, az ügynöki mesterséges intelligencia gyors hurkot igényel a GPU és a CPU között. A drága GPU-k nagy igénybevétele érdekében az ügynökök nagy egyszálú teljesítményt, nagy memória sávszélességet és alacsony késleltetést igényelnek. A Vera ezt egy monolitikus számítási szerszámmal, egy egyedi LPDDR5X memória-alrendszerrel és egy második generációs Scalable Coherent Fabric-vel éri el, új kategóriába helyezve, amely a magas egyszálú teljesítményt nagy áteresztőképességgel ötvözi.
A CPU-funkciók, az Olympus-magok és a térbeli többszálú teljesítményadó bontása
Kérdés: Az SK Hynix bejelenti a HTPU-t (Hynix Transaction Processing) – ahol alapvetően körülbelül 100 apró processzor van egy SSD-n belül, amely az ismétlődő alacsony szintű feladatokat kezeli, így az általános processzor a magas szintű feladatokra összpontosít – az NVIDIA érdeklődik a CPU-funkciók némileg hasonló bontása iránt vagy folytat?
Válasz: Az AI infrastruktúra tájképe elmozdul az egységes, all-in-one szerver csomópontoktól a magasan specializált, heterogén beállítások felé. Ennek a trendnek a kiváló példája a modern AI következtetési számítási feladatokban látható, ahol a feldolgozás különböző fázisai – az adatok kezdeti leolvasása (előzetes kitöltés) és a tokenek (dekódolás) szekvenciális generálása – most rutinszerűen teljesen különálló hardverklaszterekre oszlanak a hatékonyság optimalizálása érdekében.
„Úgy értem, azt mondanám, hogy sok, magas szintű, sok bontás történik az AI infrastruktúra területén általában, mint például, ha csak következtetést vonunk le, és hogyan különítjük el az előtöltést és dekódoljuk a külön infrastruktúrát, most ez nagyrészt a heterogén infrastruktúra trendje, ez általában nagyon is trend.”
Az NVIDIA eredeti CPU-stratégiája (a Grace processzorral együtt) a végső „gazdacsomópont” létrehozására összpontosított – egy olyan processzorra, amelyet pusztán arra terveztek, hogy adatokat tápláljon a szerverállványon belüli GPU-k fürtjébe. Az ügynöki munkafolyamatok és a megerősítési tanulás egyedi igényei azonban elfordultak, különösen azért, mert az NVIDIA rájött, hogy van egy használati eset a tiszta CPU-állványok számára az ügynöki eszközhívások és a megerősítési tanulási feladatok kezelésére.
„…a CPU-ra összpontosítottunk, a gazdacsomópontként, mivel az 1-8 vagy az 1-4 egy állványon, a lehető legjobb host csomópontot akartuk. Aztán rájöttünk, hogy valójában van egy pont, ahol valójában sok önálló CPU-t szeretne, például tiszta állványokat csak CPU-k, mert az ügynökök eszköze megerősítést igényel…”
Ennek a pivotnak köszönhetően a Vera CPU-t már nem tekintik szigorúan integrált összetevőnek, amely egy kombinált GPU-CPU architektúrába (például a Vera-Rubin verembe) tartozik. Ehelyett a Vera-t független, önálló CPU-eszközként forgalmazzák, tele van a Vera processzorok „tiszta állványaival”, kizárólag azért, hogy hatalmas mennyiségű ügynöki eszközhíváson és érvelési hurkon keresztül ropogjon.
„…ez a pivot bizonyos értelemben nagyon hasonlít a bontásra, mert azt mondod, hogy ahelyett, hogy csak a Vera-Rubin stack része lenne, úgy gondoljuk, hogy fontos, hogy a Vera önálló CPU-val rendelkezzen.
Szóval azt hiszem, bizonyos értelemben, hogy válaszoljak a kérdésedre, az a fordulat, amiben Vera önmagában is egy lépés ebbe az irányba. De nem tudom, mint abban a konkrét felhasználási esetben, amit leírt, ha valami nagyon hasonlót tervezünk.
TL; DR: Bár nem tud nyilatkozni az adott SK Hynix felhasználási esetről, az AI infrastruktúra szélesebb trendje erősen halad a bontás felé. A Verával való elfordulás egy lépést jelent ebbe az irányba, mivel az NVIDIA rájött, hogy a piacnak hatalmas önálló CPU-állványokra van szüksége az ügynöki eszközhívásokhoz és a megerősítési tanuláshoz, ahelyett, hogy szigorúan a CPU-kat használná gazdacsomópontként egy egységes veremben.
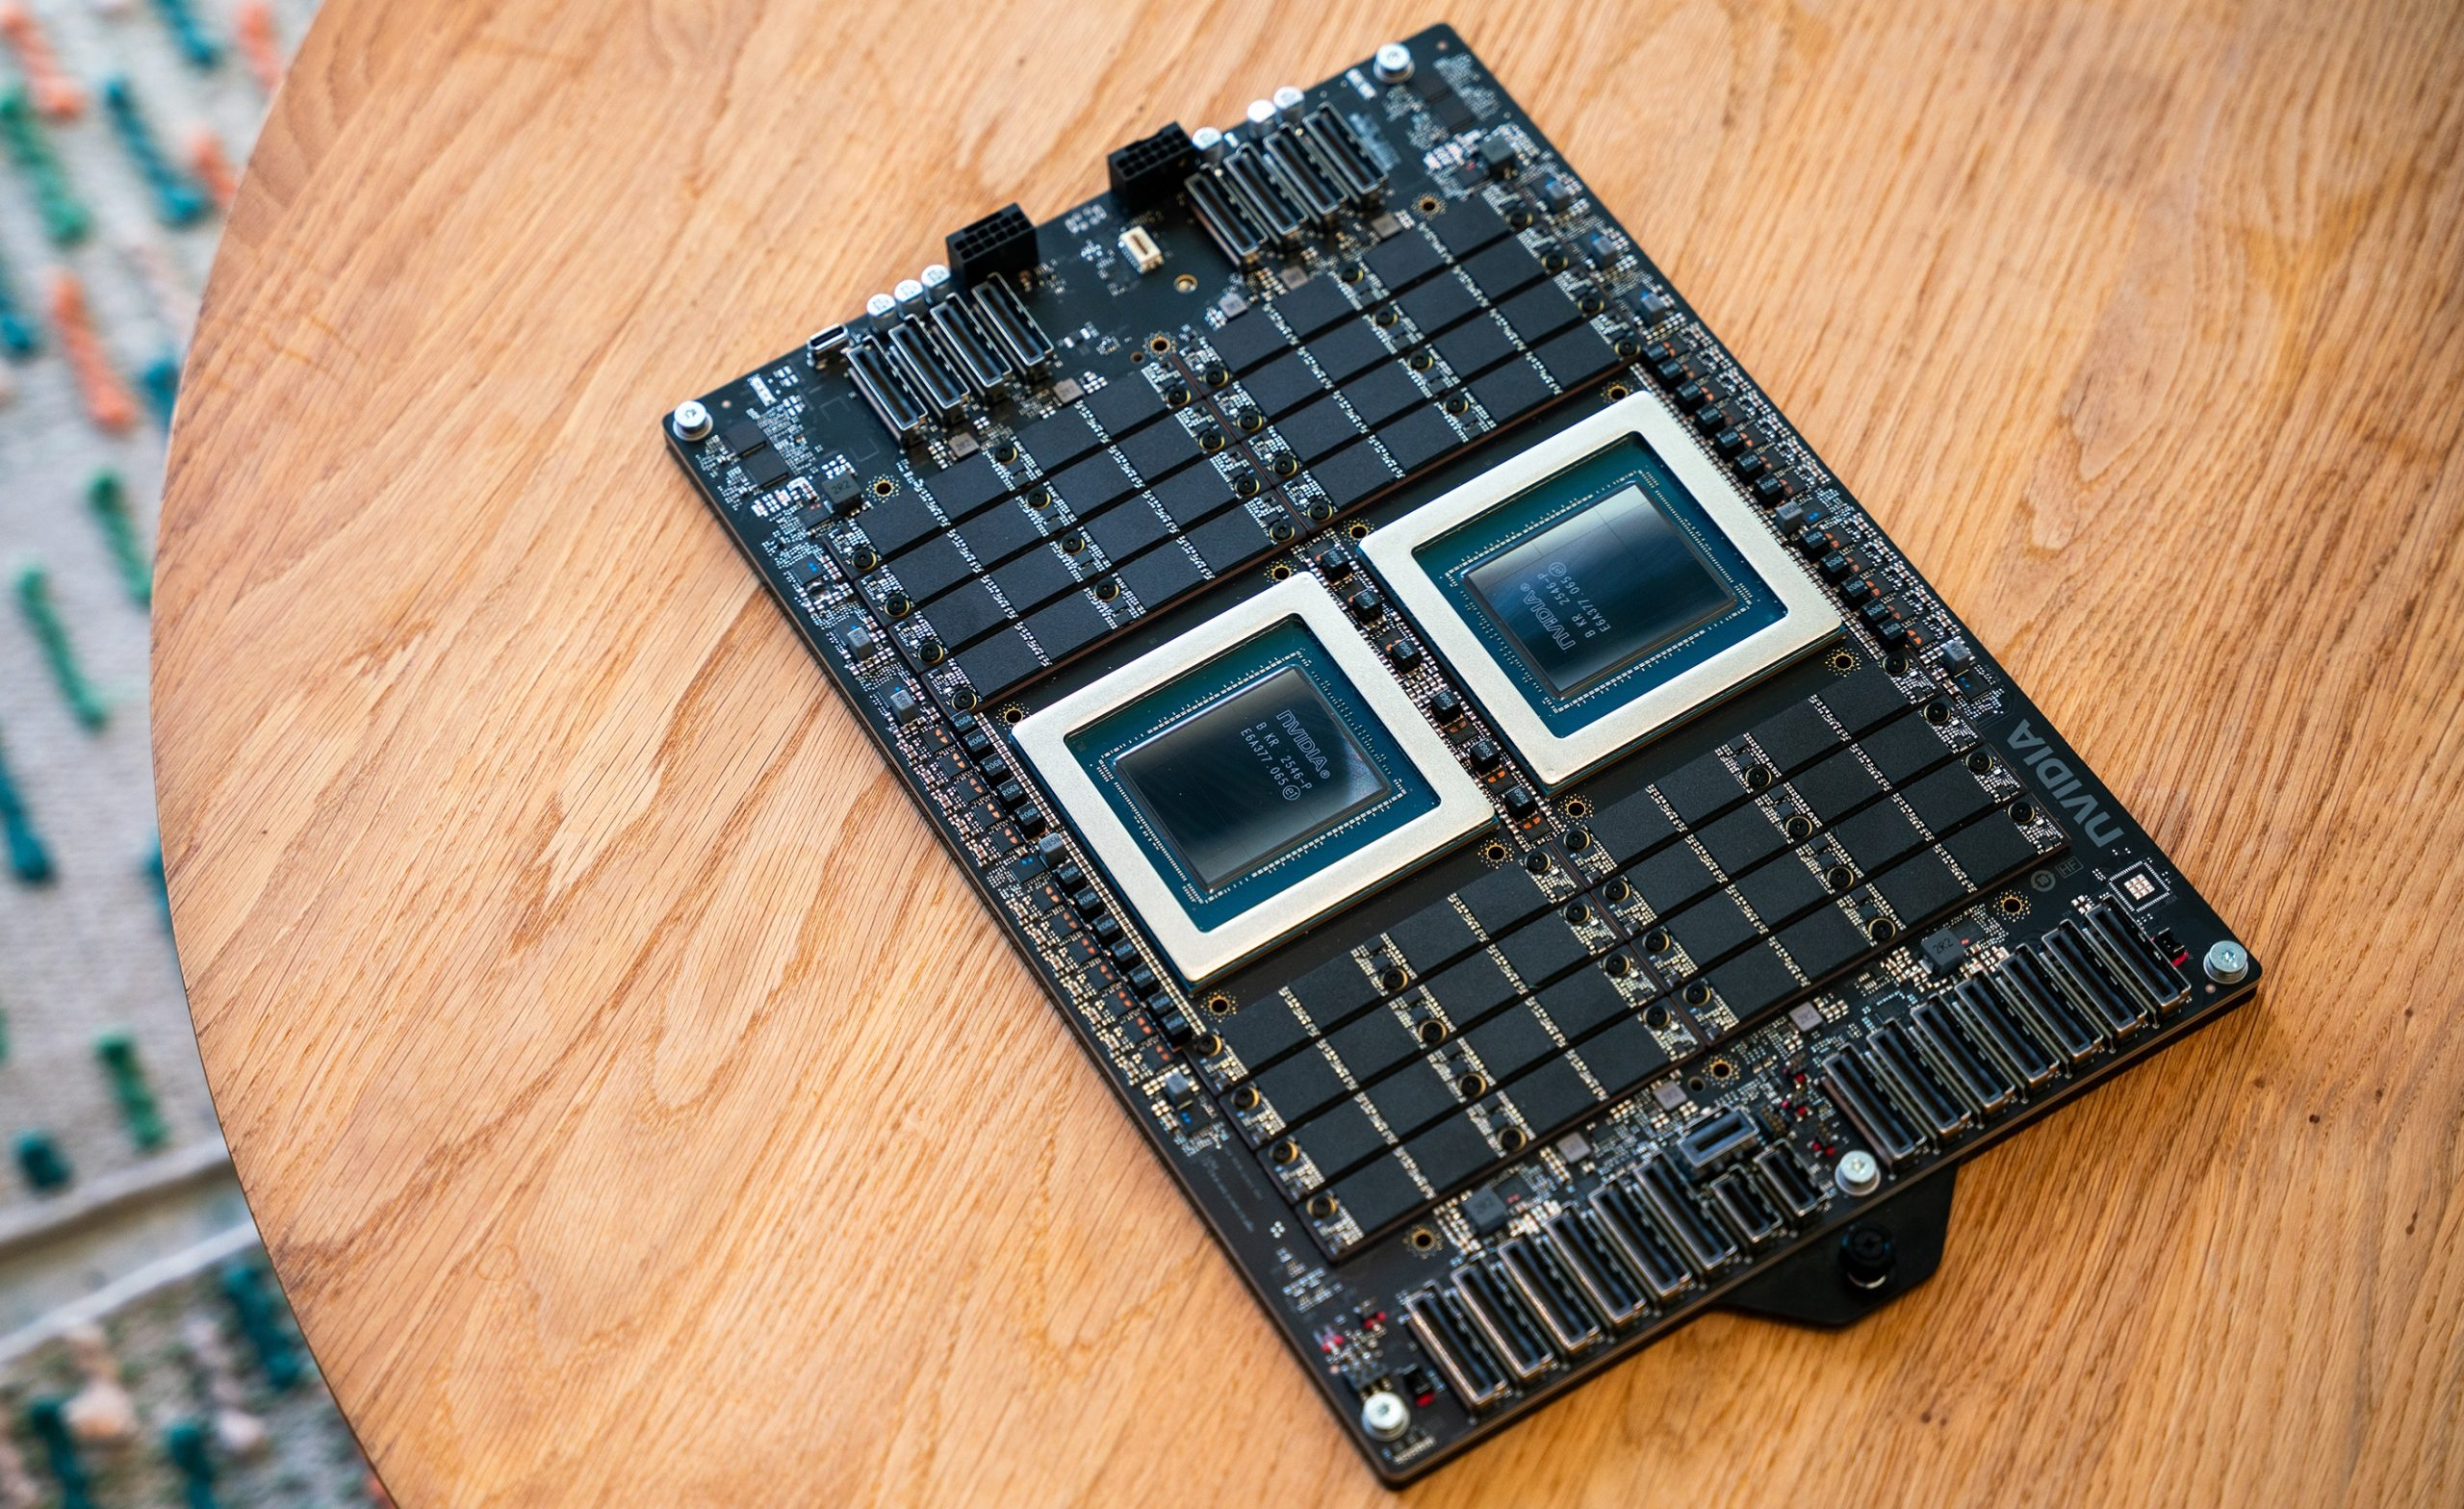
Kérdés: Tehát az NVIDIA megemlíti, hogy körülbelül 50 százalékkal magasabb az IPC-jük, mint Grace, igaz? És a CPU masszív, 10 széles dekódolási szélességgel is rendelkezik. Szóval azon tűnődtem, hogy előfordul-e téves állítás, milyen a késleltetés? Hány ciklus kell ahhoz, hogy Vera felépüljön a Grace ellen? Tudnál nekem egy nagyon durva vázlatot adni erről?
Válasz: A Vera CPU hatalmas ugrást ér el a feldolgozási teljesítményben, és 1,5x gyorsabb teljesítményt nyújt, mint elődje, a Grace. Az iparág vezető x86-os processzoraival összehasonlítva kifejezetten az ügynöki számítási feladatokkal mérve – amelyek nagymértékben támaszkodnak olyan szekvenciális feladatokra, mint a Python szkriptelés és a kódfordítás – a Vera akár 2x gyorsabban skálázható, geometriai átlag alapján 1,6x-os előnnyel.
„…1,5-szer gyorsabbak vagyunk, mint Grace, de 2-szer gyorsabbak vagyunk az ügynöki munkaterhelésnél, mint az x86. Tehát nem Grace ellen, hanem a vezető x86-os rész ellen. Kétszer gyorsabbak vagyunk az ügynöki terhelésekhez.”
Ahelyett, hogy a hagyományos egyidejű többszálú módszerekre támaszkodna, az NVIDIA egy CPU-natív képességet valósít meg, amelyet térbeli többszálúnak neveznek. Ez a szabadalmaztatott funkció lehetővé teszi a chip számára, hogy mereven biztosítsa a dedikált „munkavállaló” és „I/O” szálakat. Ez a divízió garantálja, hogy még a nehéz, adatközpont-széles számítási terhelések esetén is egy mag soha nem fogja éheztetni a ciklusok elsődleges feldolgozási szálait a háttérműveletek kezelésére.
„… Az NVIDIA saját szabadalmaztatott térbeli többszálú… Lehetővé teszi, hogy egy szálat biztosítson a munkásszálként, és egy szálat az I/O szálként. És ez egy módja annak, hogy optimálisabb erőforrás-elosztást biztosítsunk.
És ez gyakran más versengő architektúrákban is megterhel. Lehet, hogy kirabolod a munkásodat
ciklusok menete az I/O vagy más magok adagolásához a terhelés miatt. És így a térbeli
a többszálúság valójában lehetővé teszi az ilyen típusú erőforrás-egyensúly fenntartását.”
Az iparági aggályok kezelése érdekében, hogy ez az összetett szálütemezés bevezeti-e az építészeti késleltetést vagy a rezsit, a független tesztelés bebizonyította, hogy nincs teljesítményadó. A harmadik féltől származó Phoronix hardveroldal közelmúltbeli mélymerülési áttekintése igazolta, hogy az NVIDIA térbeli többszálú teljesítménye jelentős hatékonyságnövekedést eredményez.
„…azt hiszem, a Phoronix volt az, aki csak egy héttel ezelőtt tett közzé egy cikket… megerősítették, hogy a Vera-n lévő NVIDIA SMT valójában körülbelül 20 százalékos teljesítménynövekedést eredményez. Tehát nem adó, hanem éppen ellenkezőleg, az inverz.”
TL; DR: A Vera összességében 1,5x gyorsabb, mint a Grace, és különösen 2x gyorsabb, mint a vezető x86 versenytársak, kifejezetten az olyan ügynöki számítási feladatokon, mint a Python szkriptelés és az LLVM fordítás. Az NVIDIA szabadalmaztatott térbeli többszálú kezelése nem számít fel adót; inkább a munkavállalók és az I/O szálakat biztosítja az optimális erőforrás-egyensúly fenntartása érdekében még nagy terhelés mellett is. A Phoronix harmadik féltől származó elemzése megerősítette, hogy ez a többszálúság valójában körülbelül 20 százalékos teljesítménynövekedést eredményez.
Az NVIDIA véleménye arról, hogy végül hol landolhat a CPU-GPU arány
Kérdés: Amikor a Meta elindította a Muse ügynökét, néhány apróság azt sugallta, hogy a CPU-GPU arány az AI-környezetekben végül elérheti a 80:1-et. Ez reális, és hogyan befolyásolja a Vera igényét?
Válasz: Bár az NVIDIA hivatalosan nem támogatja vagy vetíti ki a 80:1 arányt, az ügynöki szerszámhívások iparági mennyisége hatalmas, egyes homokozó-szolgáltatók akár 400.000 homokozót is üzemeltetnek egyetlen ügyfél számára. Az infrastruktúra aránya aktívan erősen változik a CPU-k irányába, hogy támogassa a potenciálisan billió végrehajtó homokozót, ami az NVIDIA önálló Vera CPU-állványok iránti törekvését hajtja.
„Általában nagyon, úgy értem, hogy őszinte legyek, tudom, hogy az emberek fel fogják tenni ezt a kérdést. Mi nem
Őszintén szólva, őszintén szólva, nincs nézőpontunk az arány kérdéséről. Az emberek gyakran kérdeznek, mi pedig nem.És el tudod képzelni, miért nem akarjuk azt mondani, hogy nem akarunk semmit kitenni, mert az azonnal jelezne valamit az üzlet irányáról.
És csak annyit mondok, hogy mi a CPU-csapatban valójában nem is, fogalmunk sincs arról, hogy mi lesz a szám, de úgy gondoljuk, hogy ez egy változó szám, és ez a CPU-k irányába tolódik, és ezért fektetünk ebbe az erőfeszítésbe annak biztosítására, hogy a piac megértse, mire jó a Vera, hogy a Vera az ügynöki CPU. Ha önálló CPU-állványokat szeretne telepíteni az ügynöki vagy megerősítő tanuláshoz, reméljük, hogy erre a Verára gondol.”
NVIDIA Vera monolitikus halála
Kérdés: Miért választott az NVIDIA a Vera monolitikus szerszámát a versenytársak által használt chiplet architektúrá helyett?
Válasz: Ellentétben a régi x86-os gyártókkal, akiknek összetett, rugalmas architektúrákat kell tervezniük mind a mindennapi fogyasztók (ügyfélszámítógépek), mind a csúcskategóriás adatközpontok kiszolgálására, az NVIDIA teljesen megterheletlenül lépett be az önálló CPU-térbe, amelyet a történelmi szegmensek teljesen megterheltek. Ez az egyedülálló pozicionálás azt a luxust adta számukra, hogy a Vera-t kizárólag egyetlen célra tervezték: az ultra-nagy teljesítményű AI adatközpontra.
„…valóban a Vera az első, amit utána pozicionálunk, az, hogy nem terhelnek minket a múltbeli szegmensek… Az AMD-nek és az Intelnek nemcsak adatközpontot kell kiszolgálniuk, hanem az ügyfelet is ki kell szolgálniuk. Különböző szegmensekkel rendelkeznek, amelyeknek egyetlen architektúrával kell szolgálniuk… Valóban megvolt az a luxus, hogy az adatközpontok piacára tervezhettünk.”
Az AI-ügynökök és az adatelemzés intenzív memórianövelő hurkainak kielégítése érdekében az NVIDIA szándékosan elutasította versenytársainak többlapú trendjét egyetlen monolitikus kocka javára. Alapvetően azáltal, hogy az összes magot egy folyamatos szilíciumdarabon tartotta, az NVIDIA képes volt teljesen kiküszöbölni a belső teljesítmény „adóját”, amely akkor következik be, amikor az adatok kénytelenek keresztezni a határokat az elválasztott chipletek között.
„…egy monolitikus szerszám, ahol a chip bal felső sarkában lévő mag a chip jobb alsó sarkában lévő maghoz beszélhet anélkül, hogy átlépné az I/O határokat és támadásokat követne, ez értékes tervezési pont volt számunkra… fontos volt a tervezési pontunk számára, hogy ne csak az ügynöki mesterséges intelligencia, hanem csak az egyenes adatfeldolgozás és az adatelemzés érdekében maximalizáljuk az adatmozgásokat.”
Ez a monolitikus tervezés hatalmas teljesítményelőnyt jelent az együttműködésen alapuló számítástechnika számára. A Vera CPU soha nem látott 3,4 terabájt/másodpercnyi biszektív sávszélességet ér el, lehetővé téve az egyes processzormagok számára, hogy együttműködjenek és 3x gyorsabban osszák meg a kontextuális információkat, mint a vezető x86 chipek.
„…a 3,4 terabájt/másodpercnyi bisection sávszélességet tudunk szállítani, ami 3x magasabb, mint a vezető x86 chip. Ez azt jelenti, hogy a magoknak néha együtt kell működniük a megosztott kontextusban. És így nem, tudod, háromszor gyorsabb, ha együttműködnek a megosztott kontextusban, mint egy x86-os chip esetében.”
Míg a monolitikus megközelítésre matematikailag szükség volt a Vera konkrét teljesítménycéljainak eléréséhez, az NVIDIA rendkívül pragmatikus, agnosztikus álláspontot képvisel a chiplettechnológiával kapcsolatban a jövőben. A vállalat a chiplettervezésre fog fordulni, ha egy jövőbeli piaci lehetőség diktálja, és a mérnöki hasznosságot választja a merev tervezési filozófiák helyett.
„… Azt hiszem, csak nagyon kiegyensúlyozottak leszünk, mint például, milyen tervezési pontokat szeretnénk elérni, milyen piaci lehetőségre?… De azt mondanám, hogy ez olyan, mintha nem lennénk, azt hiszem, nem mondanám, hogy nincs vallásunk körülötte. Ez inkább olyan, mint ami helyes ahhoz, amit próbálunk elérni.”
TL; DR: Mivel az NVIDIA-t nem terhelik a régi szegmens igényei [például az adatközpont és az ügyfél igényeinek kiegyensúlyozása], azzal a luxussal rendelkezik, hogy chipjeit szigorúan adatközponti és ügynöki mesterséges intelligenciára tervezze. A monolitikus szerszám maximalizálja az adatmozgást azáltal, hogy lehetővé teszi a magok számára a chipen keresztüli kommunikációt anélkül, hogy átlépnék az I/O határokat, és másodpercenként 3,4 terabájt dB-t eredményez a szakasz sávszélességében – 3x magasabb, mint a vezető x86 chipek. Ennek ellenére az NVIDIA a jövőben is nyitott marad a chiplet architektúrákra, ha a piaci igények más architektúrát igényelnek.
Vélemény, hozzászólás?