
Az NVIDIA csendben felülvizsgálta a következő generációs Vera Rubin AI számítási platform specifikációit, csökkentve a HBM4 memória sávszélességét és a hatodik generációs NVLink sávszélességet több konfigurációban, miközben növeli a skálázható hálózati képességeket. Érdekes módon úgy tűnik, hogy a változtatások több mint egy hónappal ezelőtt történtek, ahelyett, hogy nemrégiben vezették volna be.
A Guru3D és az ITHome által kiemelt revíziókat az NVIDIA jelenlegi Vera Rubin NVL72 specifikációinak összehasonlításával igazolják ugyanazon weboldal archivált verzióival.
A Wayback Machine 2026. szeptember 1. és szeptember 11. közötti pillanatképeiből kiderül, hogy az NVIDIA felülvizsgálta a közzétett specifikációkat valamikor a dátumok között, nyilvános bejelentés nélkül.
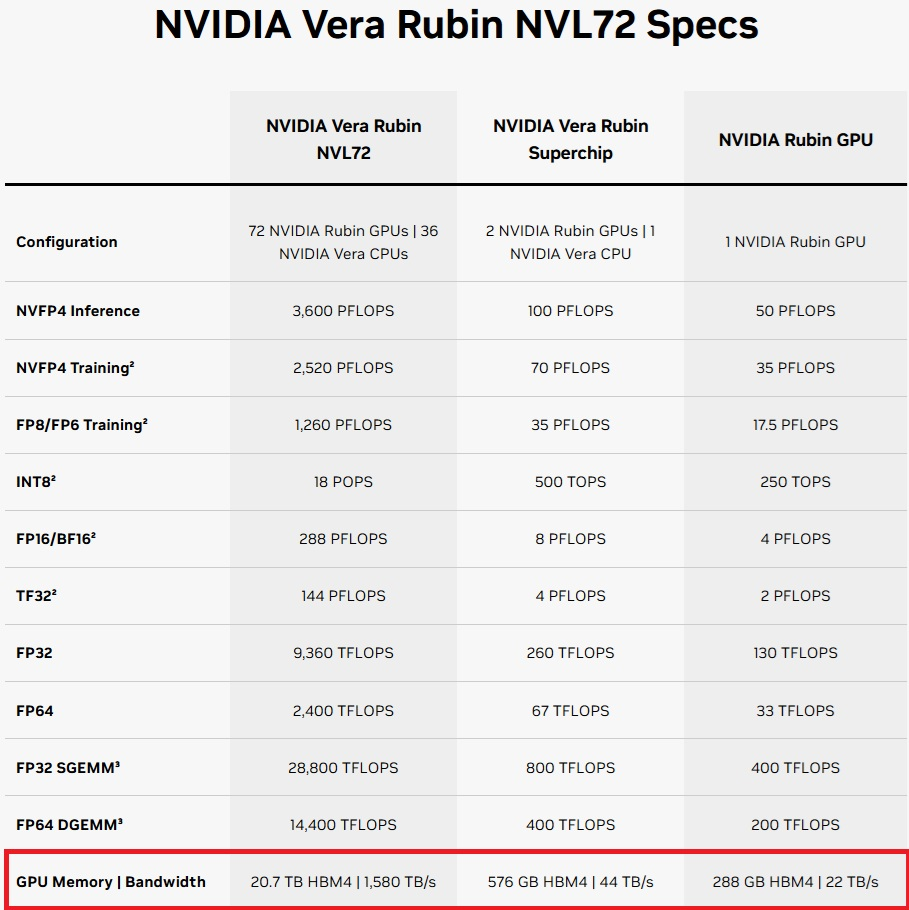
Amint arról korábban beszámoltunk az NVIDIA GTC 2026 prezentációját követően, minden Rubin GPU-t eredetileg 288 GB HBM4 memóriával hirdettek, amely 22 TB/s sávszélességet biztosított, valamint 3,6 TB/s NVLink 6 sávszélességet. Ezek a számok azóta 19,2 TB/s-ra és 3 TB/s-ra csökkentek, ami körülbelül 13%-os, illetve 17%-os csökkenést jelent.
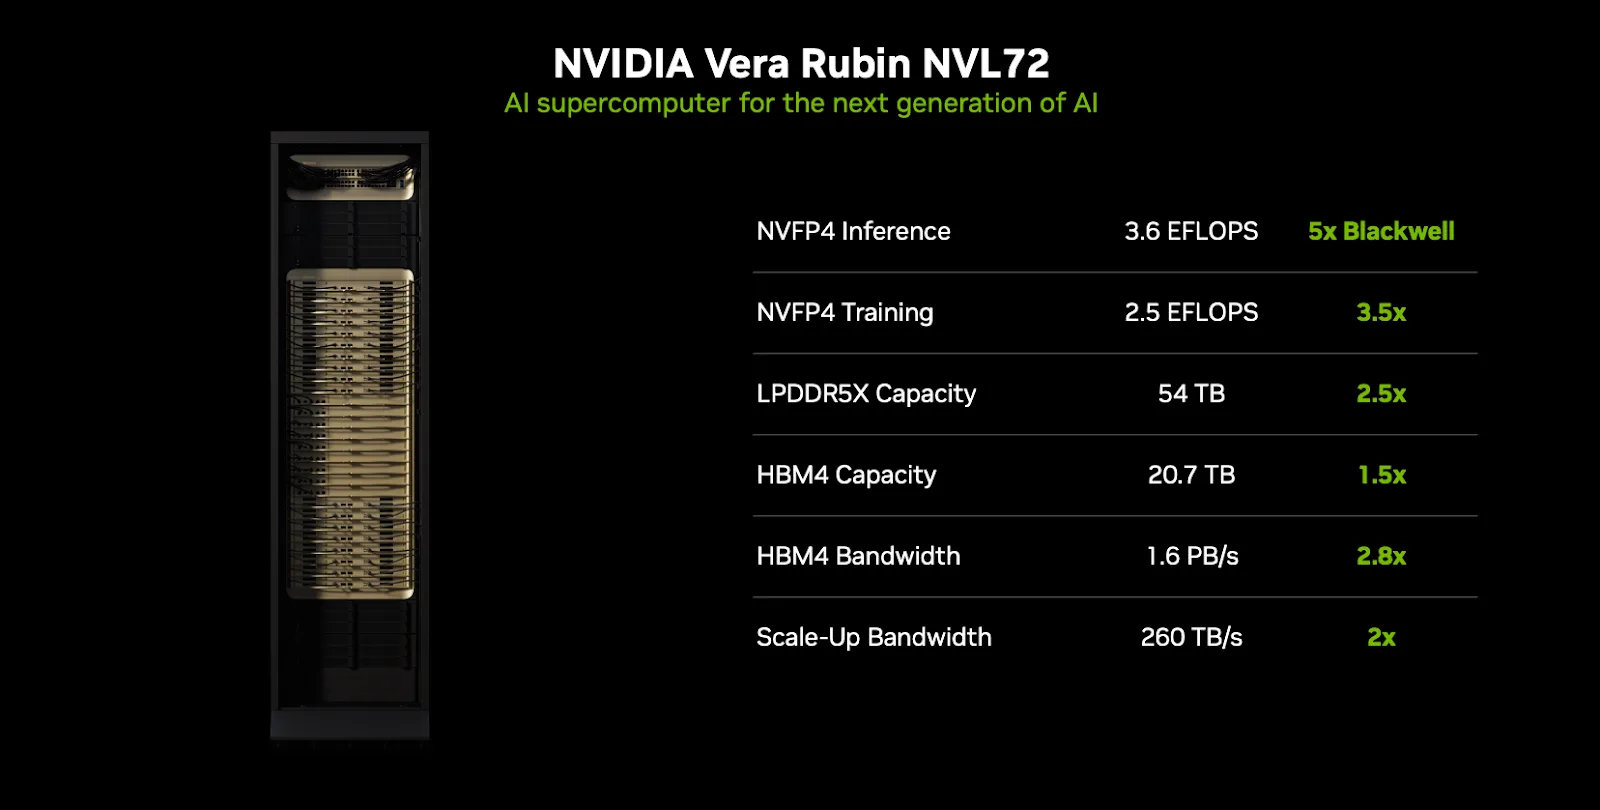
A változások kiterjednek a hatalmas Vera Rubin NVL72 konfigurációra is, amely 72 Rubin GPU-t és 36 Vera CPU-t, valamint az NVIDIA kisebb HGX Rubin NVL8 rendszereit ötvözi.
A legjelentősebb csökkenés a HGX Rubin NVL8 összesített HBM4 sávszélességét érinti, amely körülbelül 26%-kal csökkent, ami a teljes memóriakapacitás csökkenésével jár. Az NVIDIA azonban megnövelte a hálózati sávszélességet a konfigurációk között, ami potenciálisan előnyös lehet a különálló rendszerek közötti kommunikáció számára.
Érdekes módon az NVIDIA dokumentációja továbbra is következetlen. A HGX termékoldala felsorolja a felülvizsgált rendszerszintű specifikációkat, miközben továbbra is hirdeti az eredeti 22 TB/s HBM4 és 3,6 TB/s NVLink adatokat az egyes Rubin GPU-khoz. Egyes regionális NVIDIA-oldalak továbbra is a régebbi specifikációkat jelenítik meg.
Ami a csökkentések okát illeti, az NVIDIA nem adott hivatalos magyarázatot. A SemiAnalysis kutatásán alapuló korábbi iparági jelentések azonban arra utaltak, hogy a HBM4 beszállítói küzdenek az NVIDIA eredeti sávszélesség-céljainak teljesítésével. Ezeknek a követelményeknek a lazítása javíthatja a gyártási hozamokat, és segíthet a megfelelő memóriaellátás biztosításában.
Ennél is fontosabb, hogy a változások az NVIDIA által közzétett teljesítmény-specifikációkra vonatkoznak, nem pedig a mért referenciaértékekre. A zászlóshajó Rubin GPU által hirdetett 50 PFLOPS ritka NVFP4 következtetési teljesítmény is változatlan marad, ami azt jelenti, hogy a valós hatás nagymértékben függ az egyéni munkaterhelésektől, valamint a memóriára és az összekapcsolási sávszélességre való érzékenységüktől.
Vélemény, hozzászólás?