
Az AMD & Meta több millió EPYC CPU-t, köztük a hatodik generációs velencei chipeket telepítve erősíti stratégiai partnerségét.
A Meta & AMD Erősíti Partnerségét Az EPYC CPU, Az Instinct GPU És A Rack-Scale Üzembe Helyezések Révén
Ma az AMD és a Meta bejelentette stratégiai partnerségük további elmélyítését, amelyben a Meta kihasználja az AMD Helios rack-méretű megoldásait a legújabb AI modellek, például a Muse AI Agent táplálására, és napi 0 támogatást kínál a Muse Spark Open és a Muse Glimmer számára.
„A Meta az AMD stratégiai partnere, és ezt a partnerséget több éves mély műszaki együttműködéssel építettük ki – a Meta infrastruktúráját működtető EPYC processzoroktól az Instinct GPU-kig és az AI munkaterhelését támogató nyílt szoftverekig” – mondta Lisa Su, az AMD elnöke és vezérigazgatója.
„Mivel a Helios most a Meta-nál fut, ezt a partnerséget új léptékbe emeljük a szuperintelligencia korszakában. Együtt építjük és telepítjük az infrastruktúrát gigawatt skálán, és alakítjuk a szilícium, szoftverek és rendszerek jövő generációit, hogy lehetővé tegyük a Meta legambiciózusabb szuperintelligencia modelljeit és szolgáltatásait.”
A mai bejelentések részeként az AMD megerősíti, hogy a Meta-nál a kezdeti AMD Helios rack-skála rendszereket telepítik.
- A Meta több millió EPYC processzort telepített, és a hatodik generációs EPYC CPU-k vezető ügyfele.
- Az AMD Instinct GPU-k képzésben, rangsorolásban és ajánlásban készülnek.
- Az AMD a Muse Spark Open napi 0-s támogatását biztosította az Instinct GPU-kon és a Muse Glimmer-t a Ryzen AI PC-ken és a Radeon GPU-kon.
- A vállalatok kiterjesztették szoftveres együttműködésüket nagyszabású mesterséges intelligencia-képzésre, optimalizálva az Instinct MI350X GPU-k ajánlási modelljeit, és hozzájárulva a PyTorch, a Triton és a ROCm fejlesztéseihez. A Meta műszaki papírjai, amelyek működnek.
Az EPYC processzorok a Meta Muse Personal AI ügynökének alapját képezik, és a vállalat több generáción keresztül több millió EPYC processzort telepített, miközben a Zen 6 alaparchitektúrán alapuló legújabb 6. generációs EPYC „Venice” CPU-k vezető ügyfele. A Meta egy elsődleges ügyfél is, amely együttműködik az AMD-vel a jövőbeli processzorcsaládjában, mint például a Verano, amely az Agentic AI számítási feladatokhoz készült.
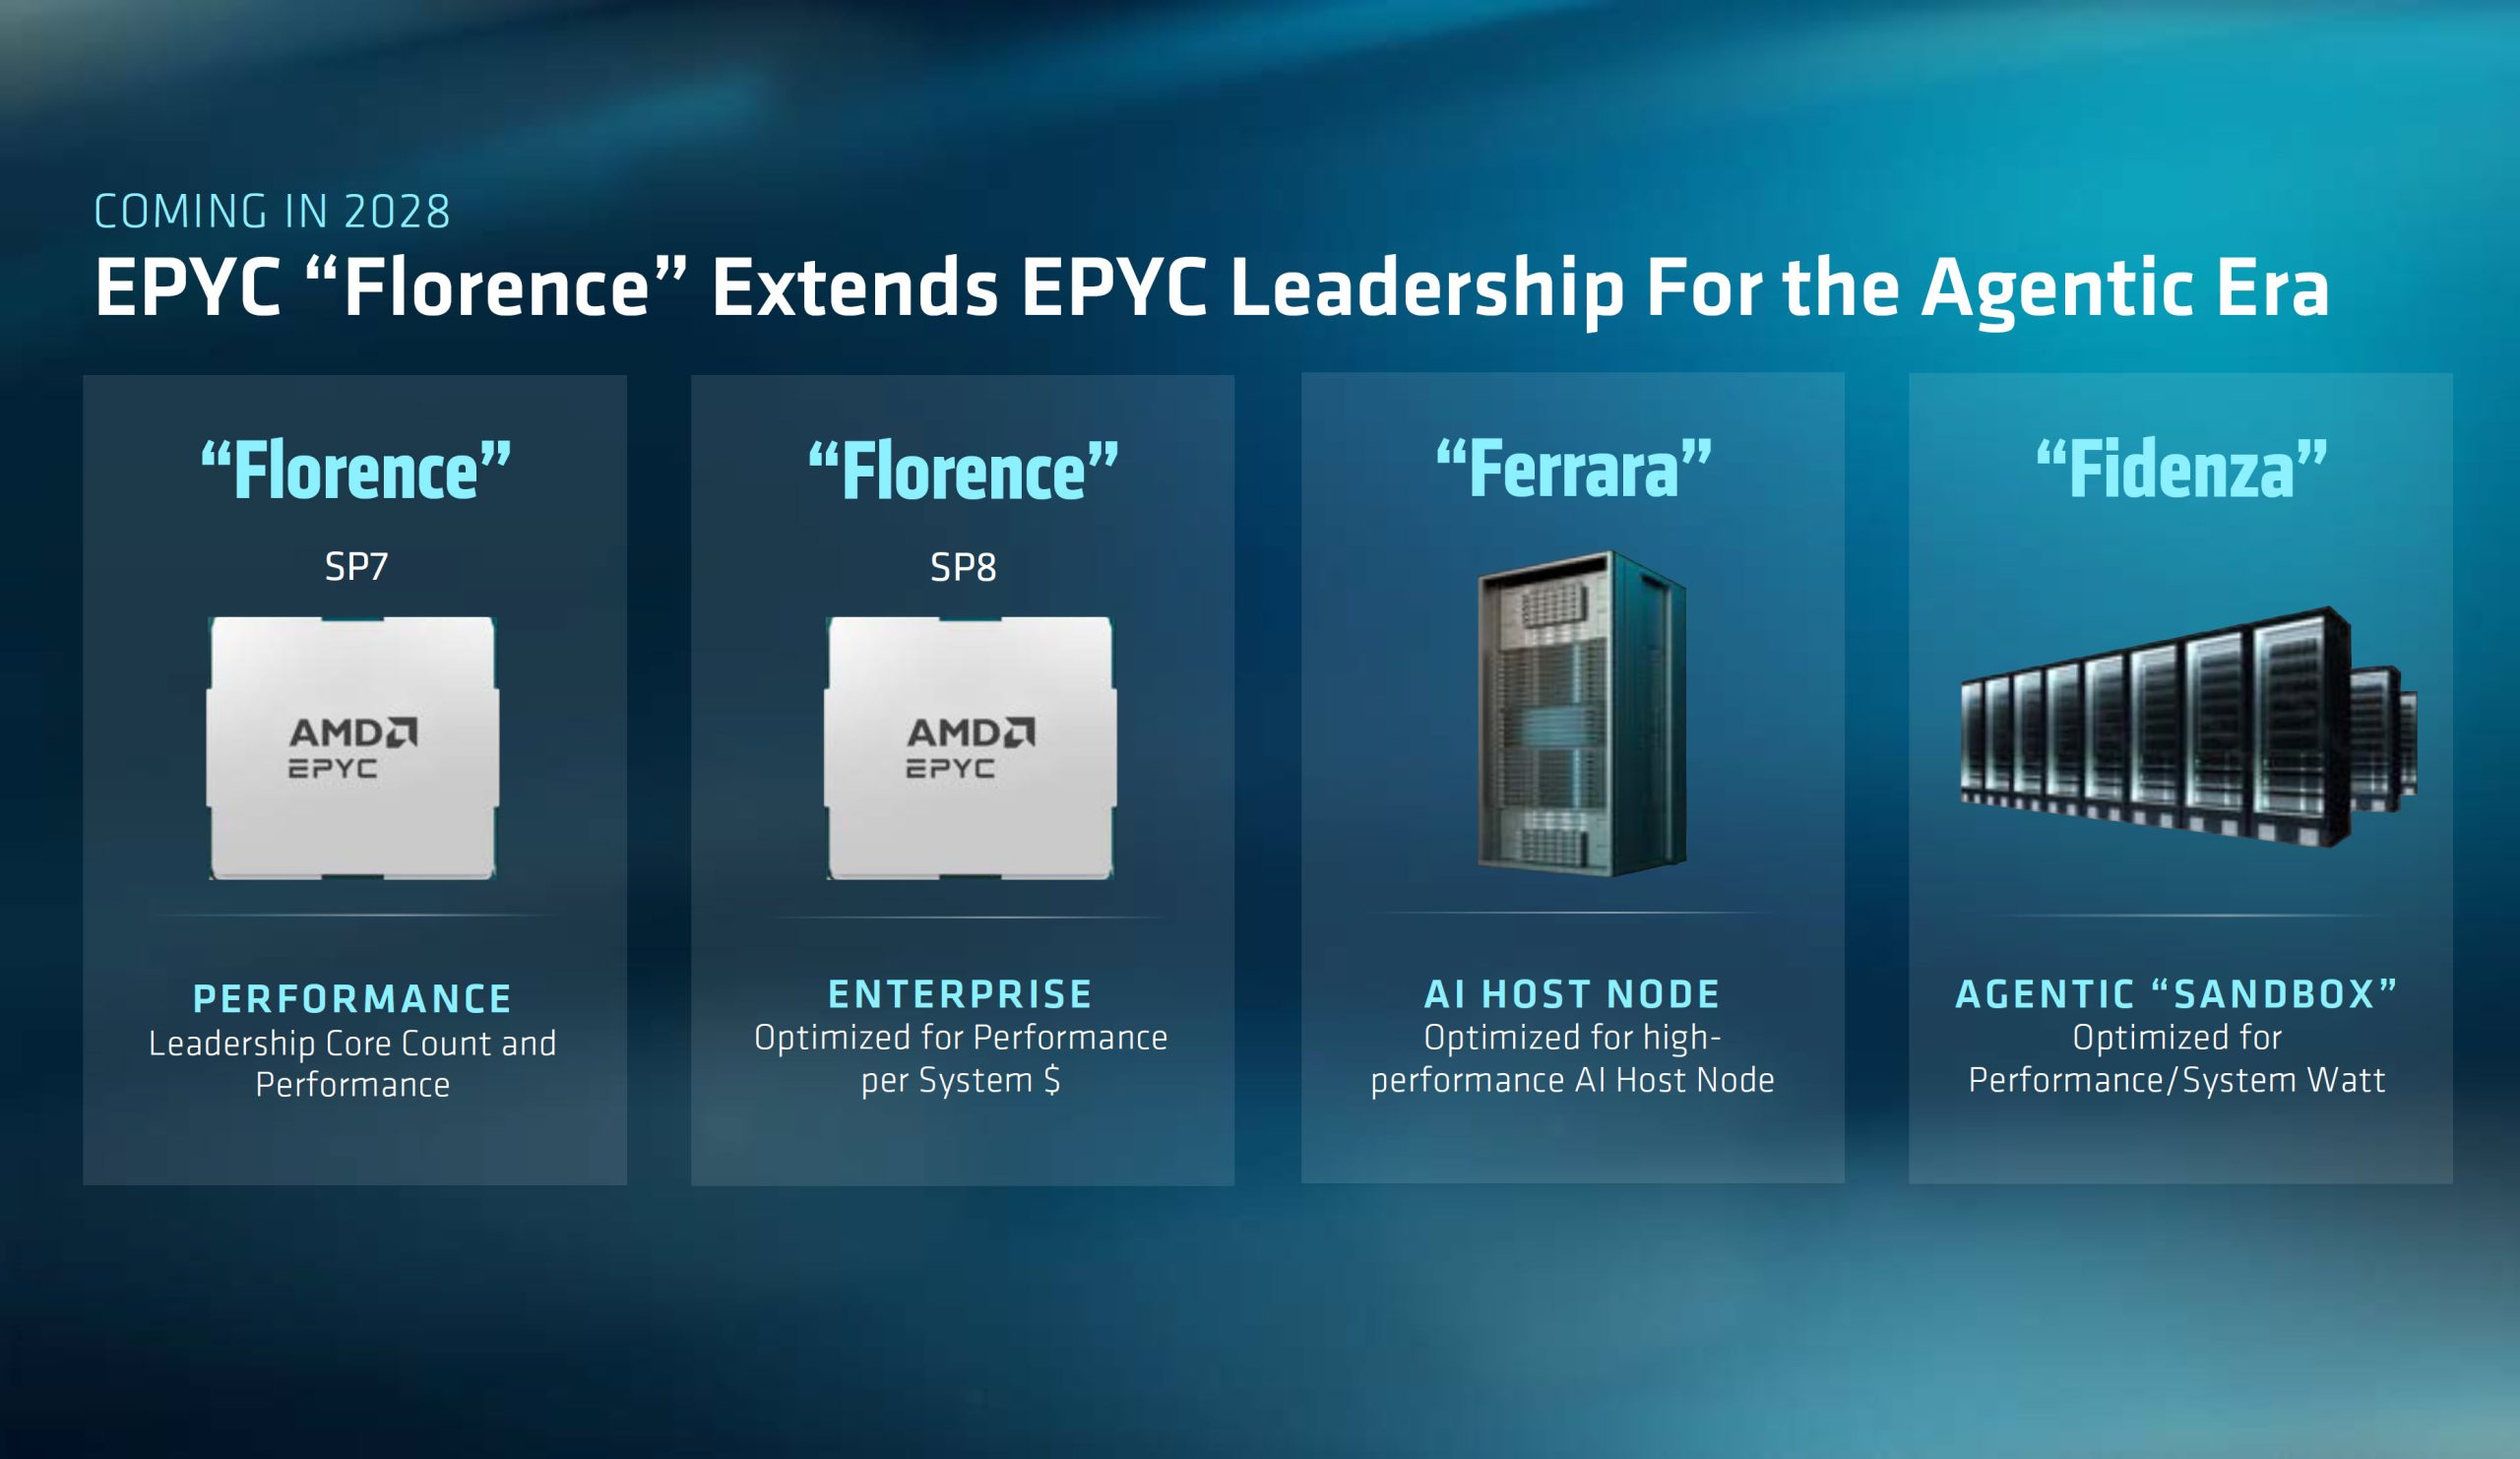
Az ösztönfronton a Meta az AMD GPU-it használja a képzéshez, rangsoroláshoz és ajánlási motorokhoz. A Meta állítólag az Instinct MI450 sorozat korai felbontású ügyfele, és egy egyedi Instinct GPU-t fog telepíteni, amely a számítási feladataihoz optimalizált. A partnerség tovább bővül a jövőbeli AMD platformokra, mint például az Instinct MI500 és a következő generációs rack-skála rendszerek, amelyeket néhány hónappal ezelőtt mutattak be.
A Meta heterogén flottát telepít, amely NVIDIA GPU-kat, AMD GPU-kat és szabadalmaztatott MTIA gyorsítókat tartalmaz a költségek csökkentése és a szállítói zárolás mérséklése érdekében. Az NVIDIA-specifikus optimalizálások kiterjedt története azonban akadályozza a teljesítmény hordozhatóságát más hardverekkel szemben. Ez a tanulmány bemutatja az alternatív gyorsítók optimalizálására vonatkozó módszereinket, az AMD Instinct MI350X versus NVIDIA B200 használatával az ajánlási modell képzéséhez esettanulmányként. Három újrafelhasználható elvet javasolunk.
Először is, a hardver-modell közös tervezés elengedhetetlen: az NVIDIA GPU-k modelljeinek közvetlen portolása helyett a modellszerkezetek és a szoftverreceptek felülvizsgálata lehetővé teszi a gyorsító-specifikus erősségek teljes kihasználását (pl. MI350X 1,6x HBM kapacitása a B200-hoz képest).
Másodszor, analitikai teljesítménymodellünk lehetővé teszi a nulla bemelegítést az optimális kernelválasztást a különböző adattípusok és mátrixformák között a gyártási modellekben, drasztikusan leegyszerűsítve a hangolást.
Harmadszor, az egyre érettebb ügynöki munkafolyamatok csökkentették a CUDA ökoszisztéma portolásának akadályát; ezeket a munkafolyamatokat kiterjesztjük a mikroarchitektúrával kapcsolatos tudatosságú kerneloptimalizáláshoz és az egyéni shim-generáláshoz. A közvetlenül portolt alapvonalhoz képest ezek a módszerek akár 1,5x-es javulást eredményeznek a végpontok közötti edzési áteresztőképességben. Tudomásunk szerint ez az első hiperskálázó jelentés az AMD GPU-k nagyméretű képzéshez való gyártásáról. Hozzájárulásainkat a nyílt forráskódú PyTorch, Triton és ROCm ökoszisztémákhoz vezettük.
Az AMD és a Meta is együtt dolgozott a ROCm előmozdításán a PyTorch-on keresztül, biztosítva, hogy a fejlesztők azonnal kihasználhassák az AMD GPU-kat. Ez lehetővé tette az AMD számára, hogy Day-0 támogatást nyújtson a Muse Spark Open modellhez az Instinct GPU-kon, míg a Muse Glimmer AMD Ryzen AI PC-ken és Radeon GPU-kon landol.
Főbb optimalizálások:
- A Muse Spark Open (816B teljes / 42B aktív MoE, 1M kontextus) egy 8x MI350X csomóponton szolgál vLLM-mel BF16-ban, MXFP4-ben és FP8-ban, valamint egy BF16 módban, amely a szakértőket MXFP4-re kerekíti terhelési időben.
- Dekódolási lépés munka (fúziós figyelemprológus és MoE véglegesítés, csúszó-ablak rétegek az AITER oldalon oldalazott figyelem, ~ 180 kevesebb kernel indítás lépésenként, pontos bf16x3 router GEMM) vette az MXFP4 ellenőrző pontot 206-ról 350 kimeneti tok/s-ra 4 egyidejű kérésnél, és 719-ről 1180-ra 32-re.
- Szakértői párhuzamosság (
--enable-expert-parallel, GPU-nként 256 szakértőből 32) 7-20%-os átviteli sebességet ad hozzá 32-128 egyidejű kérésnél az MXFP4-en, és ~24%-kal csökkenti az időt az első tokenre: 2197 tok/s 128-nál. - A hangolt AITER fúziós-MoE táblázat kis dekódoló kötegeket irányít egy egyfokozatú MXFP4 összeszerelő kernelhez, amely kihagyja a rendezést. Az egyszeri kérés-dekódolás 98-ról 114 tok/s-ra (+16%) megy a TP8-on, kódváltás nélkül: az asztal a képen látható.
- A DSpark spekulatív dekódolása, az AITER rövid lekérdezésű 3D-s figyelmi ütemezésével az ellenőrző lépéshez, és a tervezet KV-cache betétje távol marad a lefordított grafikontól, eléri a 199 tok/s egyfolyamot: +72% a TP8-on, a hangolt táblázat ugyanazon a képen, +47% 2, +31% 4, és még mindig +6%
- A GSM8K 94,4 – 95,5% marad az összes MXFP4 konfigurációban (TP, EP, hangolt asztal, DSpark).
- Pick by load: TP8 + EP8 + DSpark akár körülbelül 64 egyidejű kérés (sima TP8 + DSpark egyetlen felhasználó számára), TP8 + EP8 ezen túl.
Az EPYC CPU-k (beleértve a Velencét is), a Helios rack-skála rendszerek és az Instinct GPU-k, valamint a mély szoftver-optimalizálás és a nyitott ökoszisztémák, például a ROCM és a PyTorch kombinálásával a két vállalat lehetővé teszi a Meta legambiciózusabb modelljeit, miközben csökkenti az egyetlen gyártótól való függőséget.
Az eredmény nem csak több hardver, hanem gyorsabb, hatékonyabb út a gyártási mesterséges intelligencia felé, az ajánlórendszerektől a következő generációs ügynökökig, mindkét partnert a szuperintelligencia korszak élvonalába helyezve.
Vélemény, hozzászólás?