
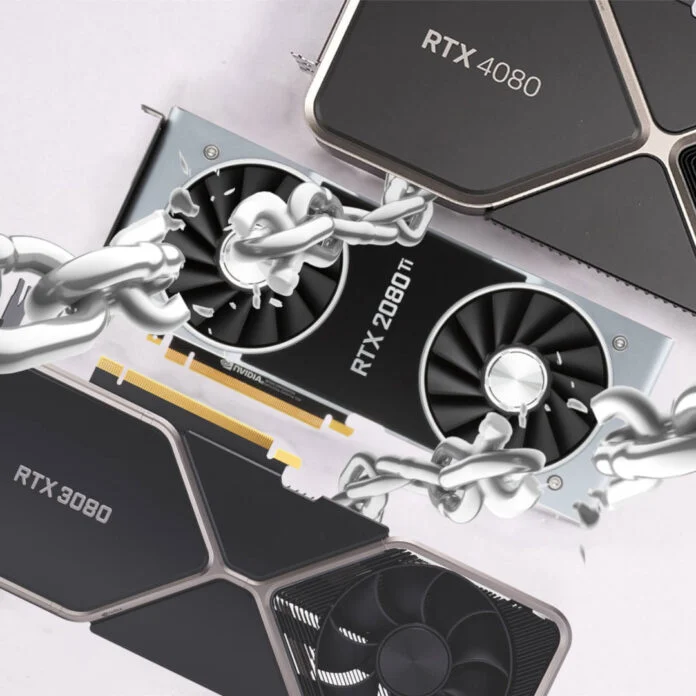
Ezek a modok eltávolítják az Nvidia szoftverzárait a fogyasztói GPU-kon, lehetővé téve számukra, hogy felszabadítsák teljes FP16-os potenciáljukat, mintha professzionális kártyák lennének.
A modderek megtalálták a módját, hogy felszabadítsák a fogyasztói Nvidia GeForce GPU-k teljes számítási potenciálját, beleértve az RTX 40, RTX 30 és RTX 20 grafikus kártyákat. Úgy tűnik, hogy ezek a modok drasztikusan növelik a GeForce GPU-k AI teljesítményét, bár a játékosok nem fognak semmilyen előnyt látni.
Az eszköz úgy működik, hogy megváltoztatja az alacsony szintű konfigurációs regisztereket, mielőtt az Nvidia illesztőprogram betöltődne, miközben felülírja a PCIe funkciószint-visszaállítást (FLR), megkerülve a szoftverzárat és feloldva az egyes GPU-k teljes potenciálját. Más szóval, ez egy ideiglenes változás, amely nem módosítja az illesztőprogramot vagy a CUDA teljesítményét, minden újraindítás után törli a törlést. Ezenkívül nincs szükség kézi javításra minden alkalommal, amikor az Nvidia új illesztőprogramot bocsát ki.
Ez elsősorban azért lehetséges, mert az Nvidia ugyanazokat a mag GPU-kat használja fogyasztói GeForce és professzionális (korábban Quadro) kártyákon, korlátozva a játékkínálat számítási teljesítményét szoftveren keresztül. Ennek a korlátozásnak a megszüntetésével a GeForce kártyák megduplázzák átviteli sebességüket, amelynél bizonyos Tensor Core utasításokat kiadhatnak. Ez elsősorban az FP16 és BF16 műveleteket érinti az FP32-felhalmozással, bizonyos TF32 és FP8 számítási feladatok mellett a támogatott architektúrákon.
Az RTX 30 GPU-kkal kezdve van egy GPU-unlock, egy olyan eszköz, amely azt állítja, hogy növeli a BF16 mátrix szorzását – amely számos neurális hálózat futtatásához elengedhetetlen – a GA102, GA103, GA104 és GA106 alapú kártyákon akár 94%-os növekedéssel. Például az alkotója a következő fejlesztéseket méri egy RTX 3090 Ti-n.
| Bemenet | Előtte | Utána |
| FP16 | 87.46 TLOPOK | 118.39 TLOPOK |
| BF16-os | 87.50 TLOPOK | 157.41 TLOPOK |
| TF32 | 42.58 TLOPS | 82.61 TLOPSZ |
Ezután van gpu-unlock-ada az RTX 40 kártyákhoz, amelyek akár 100%-os lökést is hozhatnak az AD102, AD103 és AD106 alapú kártyák teljesítményének kiszámításához, beleértve az FP16 és BF16 tensor átviteli sebességet FP32 felhalmozással. Alkotója a következő nyereséget állítja egy RTX 4090-en.
| Mód | Előtte | Utána |
| FP16 → FP32 felhalmozódás | 165.6 TLOPSZ | 331.6 TLOPOK |
| BF16 → FP32 felhalmozás | 165.5 TFLOPS | 330.6 TFLOPS |
Végül az RTX 20 modellekhez van Turing-unlock, amely akár 1,99x-rel is növeli a számítási teljesítményt. Az alábbiakban a különböző számítási feladatok teljesítményét láthatja.
| Munkaterhelés | Zárva | Feloldva | Változás |
| FP16-bemenet / FP32-akkumulációs MMA, FLOP/SM/óra | 511.6652 | 1022.4380 | 1.9983× |
| Ugyanaz az MMA, TFLOPS | 46.9361 | 93.6649 | 1.9956× |
| cuBLAS 8192 GEMM, TFLOPS, 2012 (TÉRKÉP) | 48.1488 | 85.1705 | 1.7689× |
| FP16-input / FP16-akkumulációs MMA, FLOP/SM/óra | 1022.1337 | 1022.1171 | Változatlan |
Bár mindez nagyszerű, sajnos ezek a fejlesztések egyike sem hoz semmilyen előnyt a játékosok számára; éppen ellenkezőleg. Mivel a valós idejű 3D renderelési és DLSS-funkciók már hozzáférnek a rendelkezésre álló erőforrások 100% -ához, ezek a számításorientált korlátozások semmilyen módon nem befolyásolják a játékot.
Az Nvidia zárja csak a számítási oldalon létezik, hogy megakadályozza a vállalatok és szerverek olcsóbb játékkártyák előnyeit. Más szóval, azoknak, akik számítási intenzív feladatokat, például helyi LLM-eket futtatnak, lényegesen magasabb tokenátviteli sebességet kell élvezniük.
Most, hogy a zár feltört, sok szakembert megkísértenek a GeForce kártyák, ami még magasabbra emelheti az árakat. Szerencsére a legtöbben érdeklődni fognak a magas VRAM-modellek iránt, így a low-end és a középkategóriás kártyáknak biztonságban kell maradniuk. Jelenleg a mod csak Linuxon érhető el, de a Windows támogatása valamikor jelentkezhet.
Vélemény, hozzászólás?